文章 / 2025
监督学习,基于人类反馈的强化学习和DeepSeek R1的强化学习之间的区别
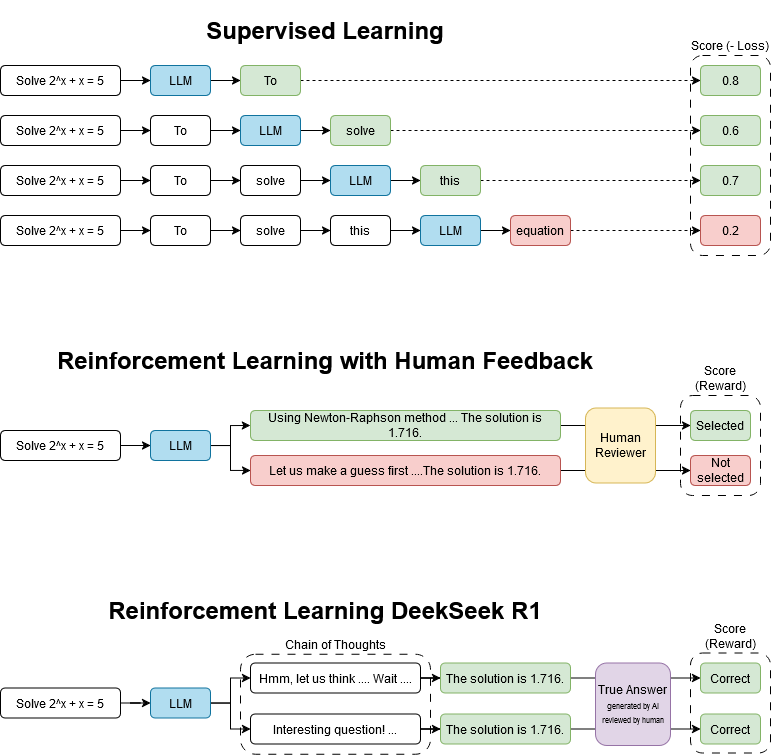
用数学课的评分方式类比三种大语言模型训练方法。
图片说明:原文中的方位描述予以保留;正文图片集中列于文末,位置未作推断。
想象一下你在解一道数学题,比如 。一般人通常会先打个草稿,尝试不同的解法(类比于AI的“思维链”或 CoT),然后才写出完整的解题过程和答案。
监督学习(传统大语言模型)
不允许写草稿,模型必须直接给出完整的解题步骤和答案。
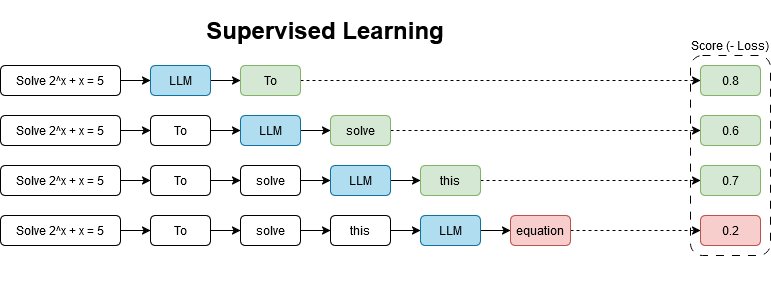
就像图片上方所示,LLM 每次只能生成一个词(token),然后这个词会和训练数据中的“标准答案”对比。
一个死板的语文老师把数学题当成古诗默写来给你打分,写错一个字就扣分。(不考虑概率的简化版)
这些惩罚累加起来,形成一个总分(或者说是负损失),训练的目标就是最大化这个分数。
模型的得分是基于所有生成的 token 计算的。
基于人类反馈的强化学习(RLHF)
不允许写草稿,模型必须直接给出完整的解题步骤和答案。
由人类来评估答案的好坏,并给出奖励(reward)。
但人类老师的打分可能会受很多因素影响,比如答案的格式、表达是否清晰,甚至个人喜好(比如数学符号是否工整,语言是否礼貌等),所以即使两个答案内容相同,也可能收到不同的评分。
图片中间部分展示了两个解法:一个说用Newton–Raphson method,另一个说先猜猜看。即便最后答案一样,但老师肯定更喜欢第一个学生。
这个方法的评分同样是基于所有生成的 token 计算的。区别是每个token在评分中比重会不一样,完全取决于人类的主观意见。
DeepSeek R1 强化学习
允许模型写草稿,写多少都无所谓,也就是可以自由地进行“思维链”推理(CoT)。
最后评分只看最终答案对不对,跟中间的草稿写了什么没有关系。
补充说明
监督学习的例子是简化过的。一个更好的比喻是,假设有一万个平行宇宙,每个平行宇宙的你都在解一道题,最后有一千个你,即10%,得出了正确的答案。最后打分根据的就是这个10%(取对数)。
DeepSeek R1 的奖励机制还会检查答案的格式,比如 LLM 生成的 CoT 是否包裹在 <think>...</think> 里,即虽然草稿怎么写无所谓,但你要把草稿写在草稿纸上,跟试卷分开。但这里为了简单起见没讲这个细节。
DeepSeek R1 论文里的 GRPO 算法很重要,但其实 https://hkust-nlp.notion.site/simplerl-reason 这篇文章表明一般 PPO 也能用。
思维链(CoT)并不是强化学习的直接产物,这篇论文 https://arxiv.org/pdf/2501.19393 证明了即使没有强化学习,也可以让模型生成很长的 CoT。
关键在于你如何评分 LLM 的答案。一个学生可能已经会推理和解题,但他的表现方式会受到老师评分方式的影响。
原文图片
以下图片按素材中的顺序列出;原文中的具体位置未知。